Un estudio de Xiao Hu, Yuansheng Lian, Ke Zhang, Yunxuan Li, Yuelong Su y Meng Li presenta LIFT, un método que ajusta un modelo de lenguaje (LLM) usando tanto datos reales de manejo de riesgo como conocimiento extraído de 299 papers académicos sobre el tema, con el objetivo de que el modelo no solo prediga el riesgo, sino que además explique con qué variables llegó a esa predicción, de forma consistente con modelos de referencia. Los resultados muestran una mejora de 26,7% en recall y 10,1% en F1-score frente a los modelos de comparación, y —el punto más relevante— el ranking de importancia de variables que generó el modelo de lenguaje coincidió con el de los modelos de referencia tradicionales, y se mantuvo estable ante distintas condiciones de muestreo de los datos.
El problema de fondo: predecir bien, pero no poder explicar por qué
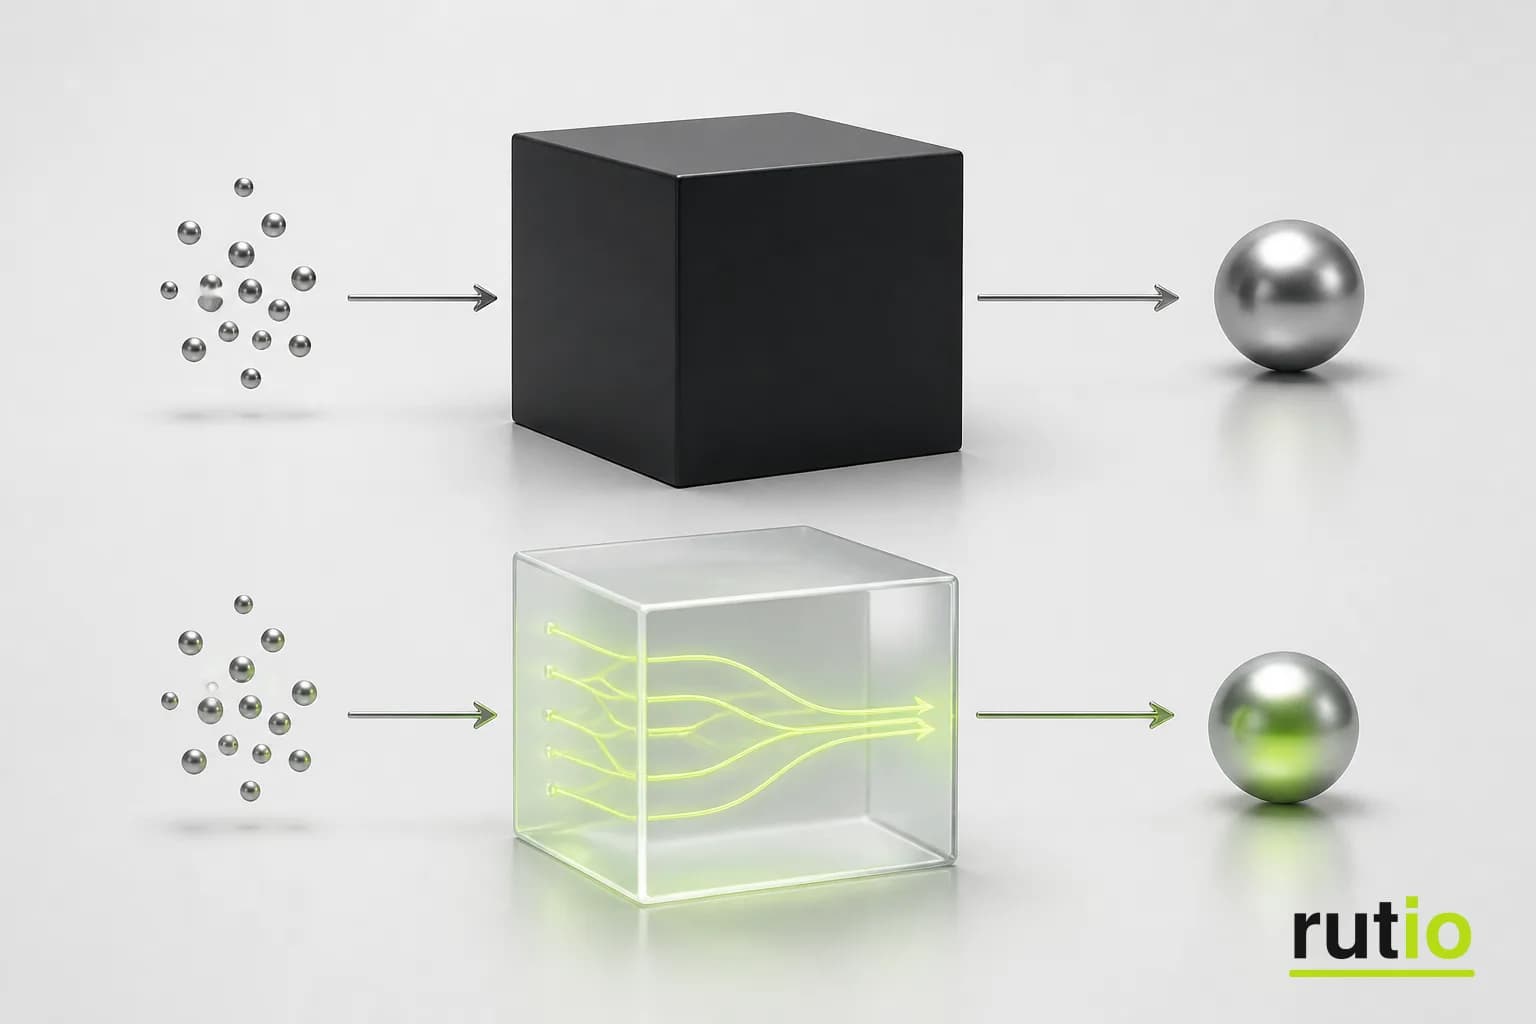
Muchos de los modelos de machine learning más precisos para predecir riesgo de conducción funcionan como "cajas negras": entregan una predicción confiable, pero es difícil entender con qué lógica llegaron a ella. Eso es un problema práctico, porque a un gerente de flota o a un conductor le sirve mucho más una alerta de riesgo si además le dice qué variable específica la generó.
El estudio LIFT propone resolver esta tensión combinando dos fuentes: datos reales de manejo de riesgo, y una base de conocimiento construida a partir de 299 papers académicos sobre el tema, filtrados especialmente para el entrenamiento del modelo de lenguaje.
Cómo funciona: literatura científica + datos reales
El método combina tres componentes: un motor de inferencia basado en un modelo de lenguaje ajustado específicamente para esta tarea, un proceso que filtra y organiza el conocimiento de 299 papers académicos sobre riesgo de manejo en una base consultable, y un evaluador que mide tanto el desempeño predictivo del modelo como su capacidad de explicar sus propias predicciones.
El resultado, frente a los modelos de referencia usados como comparación, fue una mejora del 26,7% en recall (la capacidad de detectar los casos de riesgo real que existen) y del 10,1% en F1-score (una medida que combina precisión y sensibilidad). El sistema además identificó combinaciones específicas de variables asociadas a escenarios riesgosos, verificadas con pruebas estadísticas formales.
Por qué la parte "explicable" es la que más importa acá
El hallazgo más relevante del estudio no es la mejora en la métrica de predicción, sino que el ranking de importancia de variables generado por el modelo de lenguaje coincidió con el de los modelos de referencia tradicionales —y ese ranking se mantuvo estable incluso al cambiar la forma en que se muestrearon los datos—. Eso es evidencia de que la "explicación" que da el modelo no es una historia inventada después de la predicción, sino algo consistente con lo que otros métodos también identifican como relevante.
Para cualquiera que evalúe un score de conducción basado en IA, esto marca una diferencia importante entre un sistema que solo entrega un número de riesgo, y uno que además puede señalar qué variables específicas —velocidad, frenadas, contexto de manejo— llevaron a esa conclusión, algo mucho más útil a la hora de decidir qué acción tomar con un conductor concreto.
¿Qué significa que un modelo de IA sea una "caja negra"?
Es un modelo que entrega una predicción confiable pero cuyo proceso interno de razonamiento es difícil o imposible de entender para un humano, incluso para quienes lo diseñaron. Contrasta con un modelo "explicable", que además de predecir, puede mostrar qué factores pesaron en esa predicción.
¿El estudio se hizo con datos de vehículos livianos o de transporte pesado?
El estudio original se centra en riesgo de manejo de camiones. El principio de fondo —usar literatura científica para hacer que un modelo de lenguaje explique sus predicciones de forma consistente con métodos de referencia— es una técnica general de IA aplicable a cualquier segmento de manejo, no específica de un tipo de vehículo.
¿Esto significa que ya existe una IA que reemplaza el análisis humano de riesgo?
No. El estudio muestra que un modelo de lenguaje puede acercarse o superar a los modelos de referencia en la predicción y, además, ofrecer una explicación consistente de sus resultados. Eso es una herramienta de apoyo para quien analiza el riesgo, no un reemplazo del criterio de un gerente de flota o un analista.