Un estudio de Yann Cherdo, Benoit Miramond, Alain Pegatoquet y Alain Vallauri, publicado en 2023, comparó redes neuronales recurrentes y convolucionales de distinto tamaño para detectar anomalías en series de tiempo de sensores de un auto real, capturadas desde el CAN-bus. El hallazgo central: modelos mucho más chicos, con hasta 23% menos parámetros y cálculos, lograron un desempeño de detección prácticamente equivalente al de los modelos más grandes. Esto importa porque el costo computacional es justamente lo que limita meter este tipo de detección de fallas dentro de un dispositivo embebido barato, en lugar de depender de enviar todo el dato crudo a un servidor para analizarlo ahí.
Por qué el tamaño del modelo es un problema real
Detectar una anomalía en los datos que viajan por el CAN-bus de un auto —una lectura de sensor que se sale de su patrón habitual, antes incluso de que dispare un código de falla— es una tarea que técnicas de machine learning resuelven bien. El problema es que los modelos más precisos suelen ser también los más pesados de correr, algo que en la práctica hace difícil incluirlos dentro de un dispositivo pequeño instalado en el vehículo.
Los autores del estudio construyeron detectores de anomalías no supervisados —es decir, que no necesitan ejemplos etiquetados de "esto es una falla" para aprender— sobre series de tiempo reales de sensores de un auto, y probaron arquitecturas de distinto tamaño para ver cuánto se podía reducir el modelo sin perder capacidad de detección.
El resultado: casi el mismo desempeño con modelos más chicos
La comparación mostró que era posible reducir la cantidad de parámetros y de cálculos de los modelos hasta en un 23%, manteniendo un nivel de detección de anomalías prácticamente equivalente al de los modelos más grandes y costosos. En otras palabras, gran parte del "peso" de los modelos más grandes no se traducía en mejor detección real.
Esto tiene una implicancia práctica directa: un sistema de detección de fallas puede vivir dentro de un dispositivo instalado en el auto, sin depender de enviar el dato crudo a un servidor externo para procesarlo, lo que reduce tanto el costo de conectividad como el tiempo que pasa entre que ocurre la anomalía y que alguien se entera.
Qué implica esto para un GPS OBD2 de flota
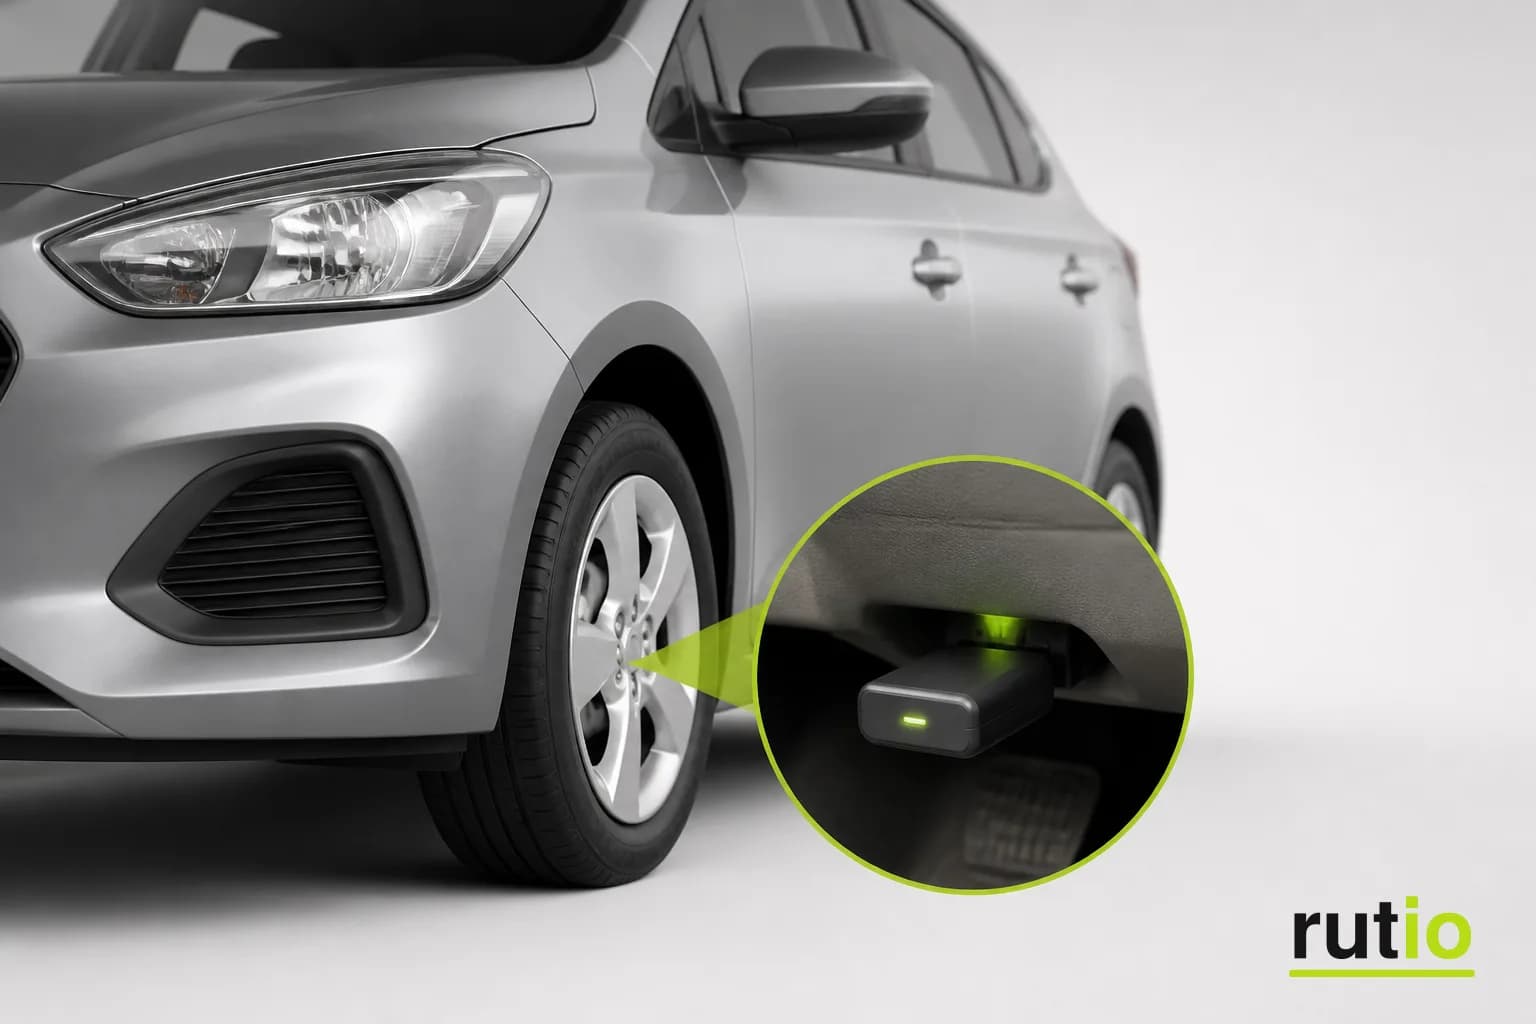
Un dispositivo de telemetría instalado en el puerto OBD2 de un vehículo tiene, por diseño, capacidad de cómputo limitada: no es una computadora de escritorio, y no debería necesitar serlo para hacer bien su trabajo. Este estudio es evidencia de que gran parte de la detección temprana de anomalías —la que hoy alimenta alertas como las que muestra un DTC o un patrón fuera de lo normal en un sensor— no exige el modelo más grande posible, sino el mejor ajustado al problema.
Para una flota, la conclusión práctica es que no hace falta elegir entre "detección sofisticada" y "dispositivo liviano y económico": la evidencia muestra que se puede tener ambas cosas al mismo tiempo, siempre que el modelo esté bien diseñado para el tamaño del problema real.
¿Qué es una detección de anomalías "no supervisada"?
Es un enfoque de machine learning que no necesita datos previamente etiquetados como "falla" o "normal" para aprender: el modelo aprende el patrón habitual de los datos y señala como anomalía todo lo que se desvía significativamente de ese patrón.
¿Esto reemplaza a los códigos de falla (DTC) que ya genera el auto?
No. Los códigos DTC los genera la ECU del vehículo cuando detecta que un valor supera un umbral definido de fábrica. La detección de anomalías por machine learning puede identificar patrones inusuales antes de que lleguen a ese umbral, funcionando como una capa adicional de alerta temprana.
¿Por qué importa que el modelo sea liviano si al final el dato se ve en una app?
Porque cuanto más procesamiento puede hacer el propio dispositivo instalado en el vehículo, menos depende de la conectividad celular y del tiempo de ida y vuelta a un servidor para avisar de un problema, lo que en la práctica significa alertas más rápidas y un dispositivo más económico de fabricar y operar.